
自学习诱捕优化
自学习诱捕优化
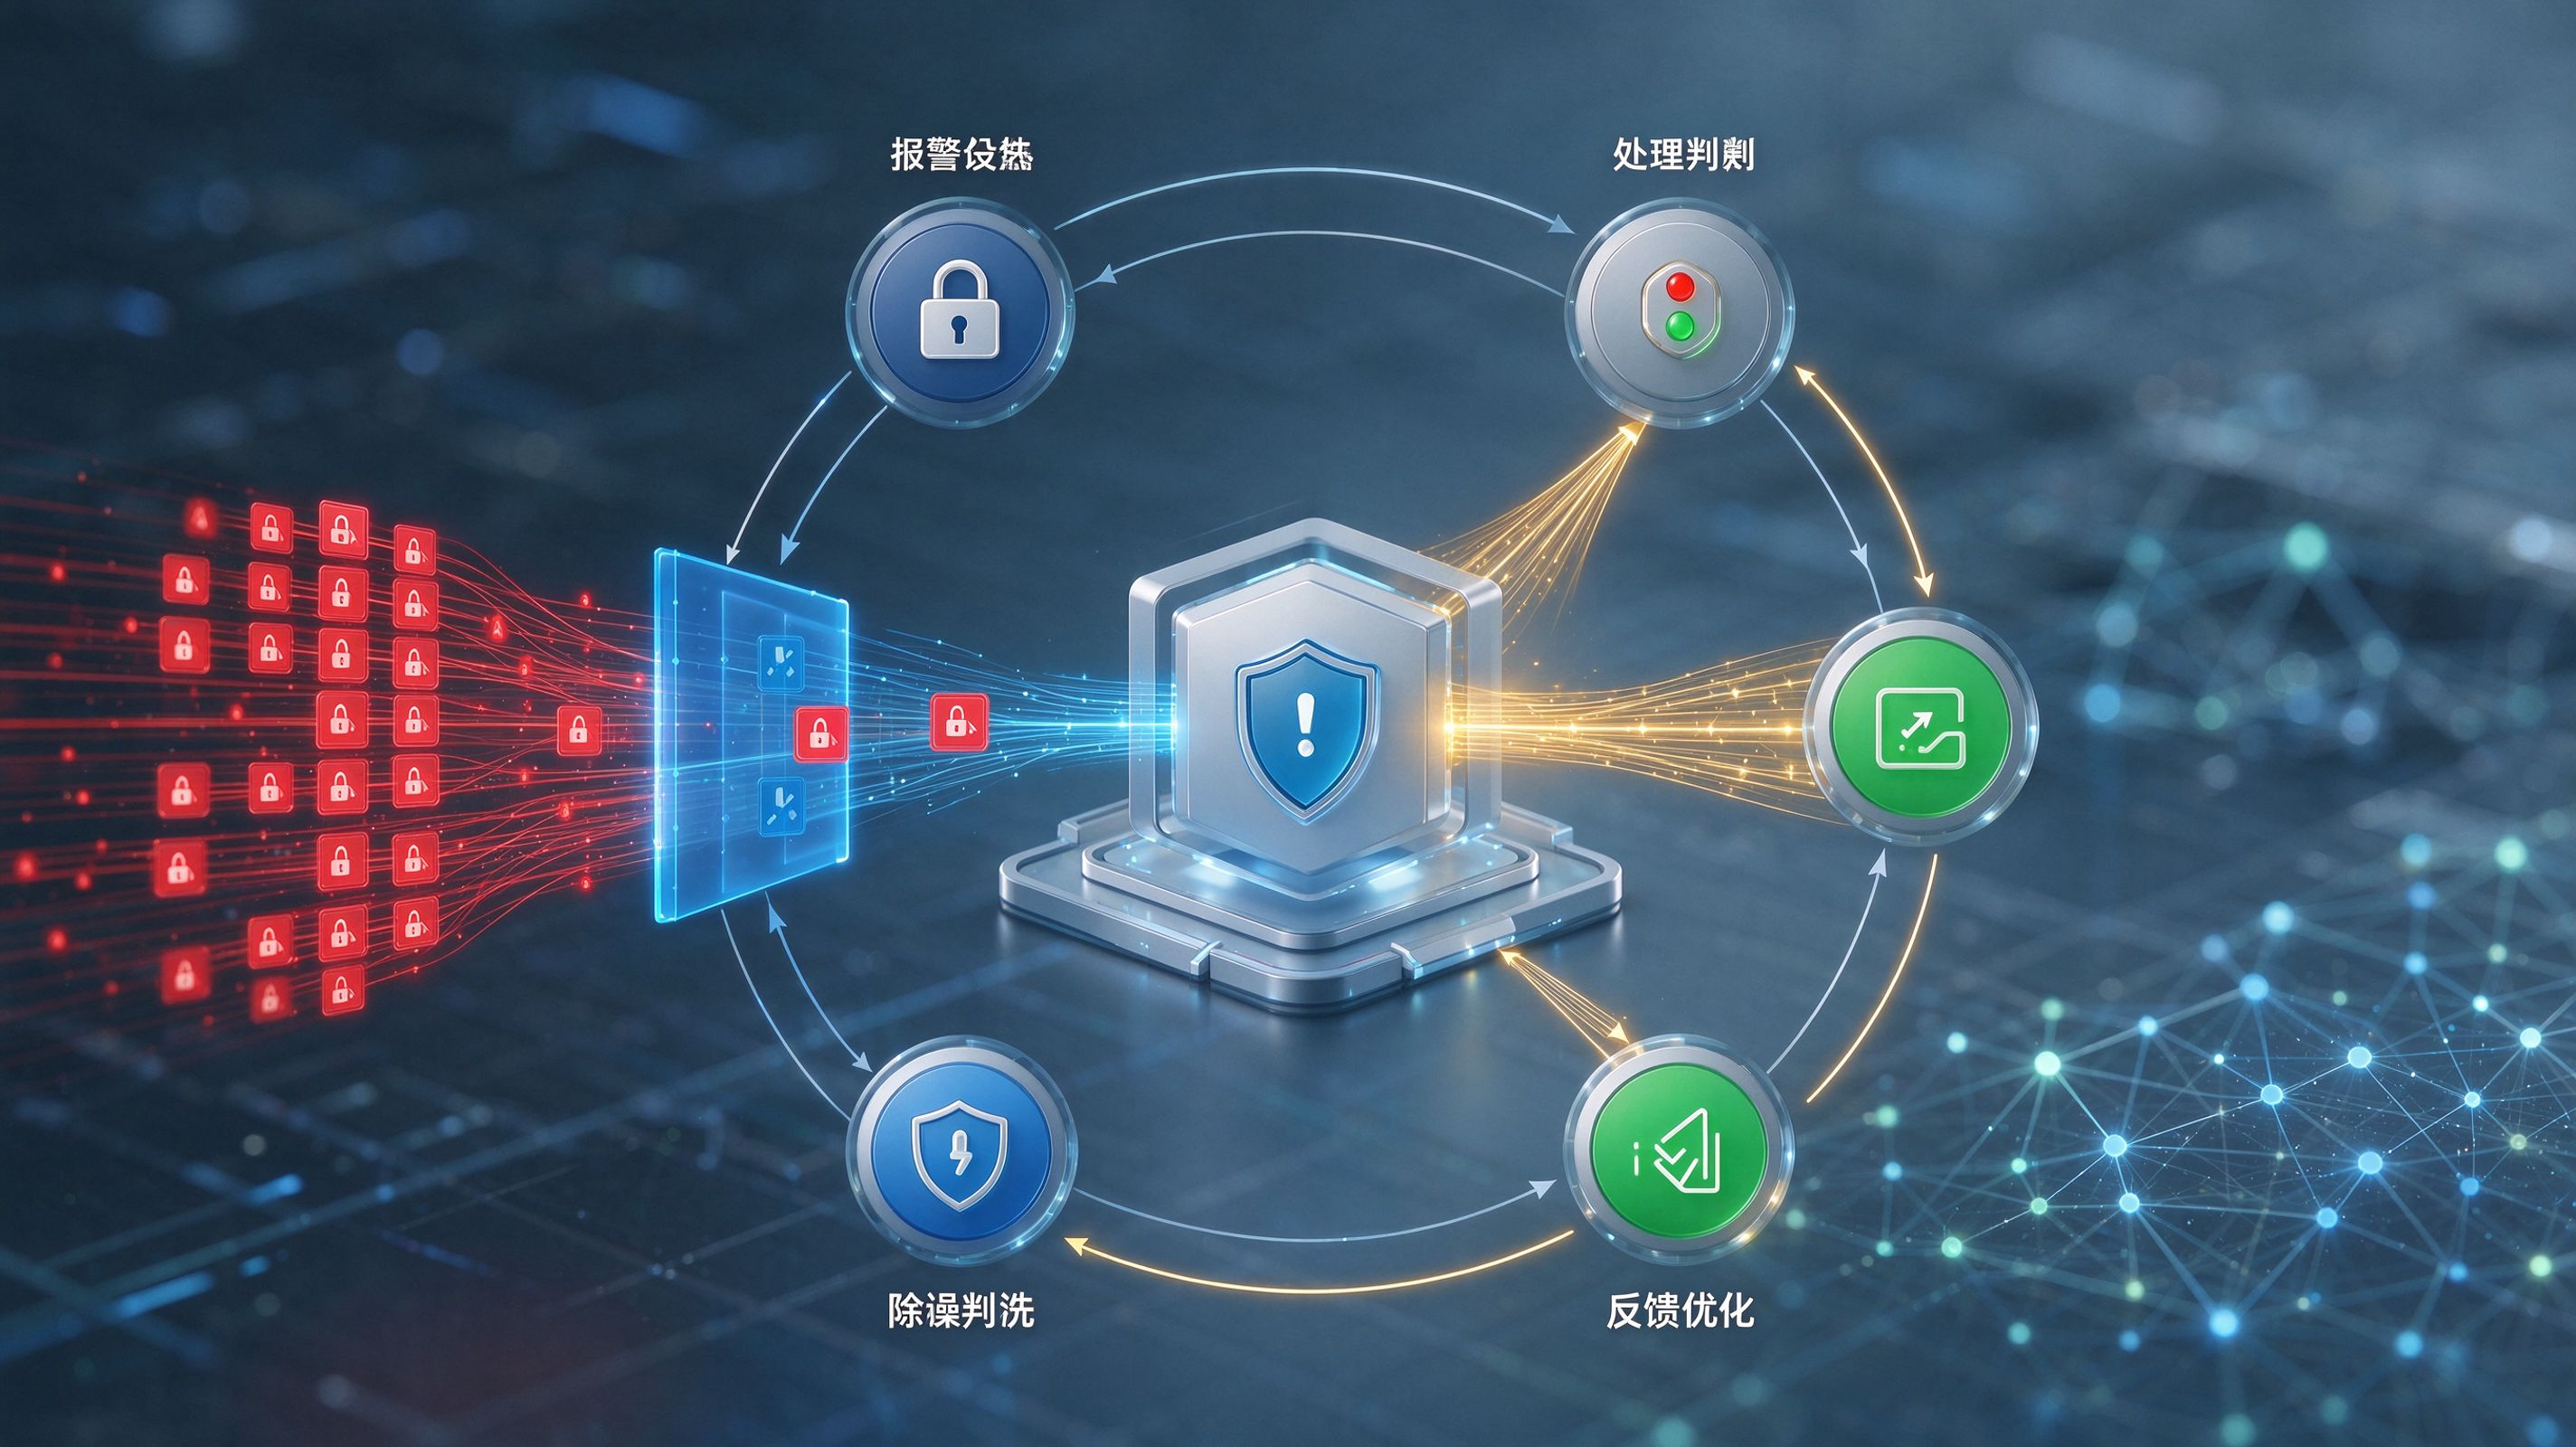
基于攻击样本持续优化诱饵形态与检测规则。以“样本采集—特征沉淀—诱饵优化—规则下发—效果验证”为闭环,把蜜罐诱捕到的攻击样本、工具指纹、行为序列与误报反馈转化为可复用特征,持续调整服务伪装、页面内容、文件诱饵、账号诱饵与漏洞诱饵,并优化检测规则、告警阈值与工具识别模型,做到“样本越用越准、诱饵越用越真、规则越用越精”。
功能详解
自学习模块帮助企业在蜜罐诱捕过程中沉淀攻击样本与行为特征,将样本转化为诱饵优化与检测规则迭代的依据,让诱饵更贴近真实业务、规则更贴合实际攻击手法,减少固定诱饵易被识别、固定规则易误报漏报的问题。
攻击样本采集与特征沉淀
【样本采集】
自动归集诱捕节点上的扫描请求、爆破尝试、漏洞利用载荷、投递文件、WebShell与C2回连样本,保留来源、时间、协议与工具指纹。
【特征沉淀】
从样本中提取请求路径、参数特征、命令序列、文件哈希、TLS/JA3与User-Agent等特征,形成可复用的诱饵与检测特征库。
【反馈标注】
结合安全运营人员的确认、误报标记与处置结果,对样本与规则效果进行标注,为后续优化提供可信反馈。
诱饵形态自优化
【服务伪装优化】
根据攻击者常探测的服务、路径与版本特征,持续调整Web、文件、数据库、远程管理等诱饵服务的伪装形态与响应细节。
【内容诱饵优化】
基于被攻击的页面、文件与账号诱饵效果,优化诱饵名称、目录结构、页面内容与文件类型,让诱饵更贴近真实业务环境。
【漏洞诱饵优化】
按样本中高频利用的漏洞类型与利用方式调整漏洞诱饵,提升对扫描器、漏洞利用工具与自动化攻击的吸引力。
典型场景
覆盖诱饵动态伪装、规则持续调优与误报抑制
外网诱捕诱饵动态伪装

内网蜜罐规则持续调优
误报抑制与运营闭环
产品优势
样本越用越准、诱饵越用越真、规则越用越精
样本驱动,诱饵“越用越真”用真实攻击样本反推攻击者关注的服务、路径与内容,持续调整诱饵形态,减少固定诱饵被轻易识别的问题,让诱捕节点更像真实业务。
规则进化,检测“越用越精”基于新样本与误报反馈迭代工具指纹、行为规则与告警阈值,补充新工具、新载荷与新手法特征,在降低误报的同时保持对真实攻击的敏感度。

闭环运营,效果“越用越稳”从样本采集、特征沉淀、诱饵优化、规则下发到效果验证形成闭环,优化结果可灰度验证、可回退、可审计,让诱捕效果随运营持续提升而不是一次性配置。