员工把代码喂给AI怎么办?三周落地企业AI使用治理实战
背景
前阵子领导甩给我一个问题:安全部门发现,研发同事现在写代码、查问题,几乎都离不开 AI——但不少人是直接把公司源代码、项目方案、甚至客户数据整段贴进对话框。这些数据一旦提交,就到了第三方 AI 平台的服务器上,留没留、用没用来训练,谁也说不准。
要求很明确:不能一刀切禁用(业务确实提效),但必须把数据安全管起来。我前后花了三周落地,这篇把整个过程、时间线、速查表和踩的坑都整理出来,给同样要做这件事的同行一个参考。
一、先搞清楚:AI 泄密到底漏在哪
很多人以为"泄密"是 U 盘拷文件那种,AI 泄密完全不一样,它有几个特点:
没有任何拷贝动作:员工只是打字、粘贴,传统文件外发审计在外观上看不出异常;
数据直接发给第三方:提示词随请求上传到 AI 厂商服务器,企业完全不可控;
全员都在用:从研发到运营、财务,人人都可能用,门槛极低;
提示词内容默认不可见:不专门采集,你根本不知道员工问了什么。
所以治理的核心不是"禁 AI",而是**“看得见内容、分得出风险、管得住通道、给得了替代”**。
二、三周落地时间线
我们把整个过程拆成了三段,每段一周左右。
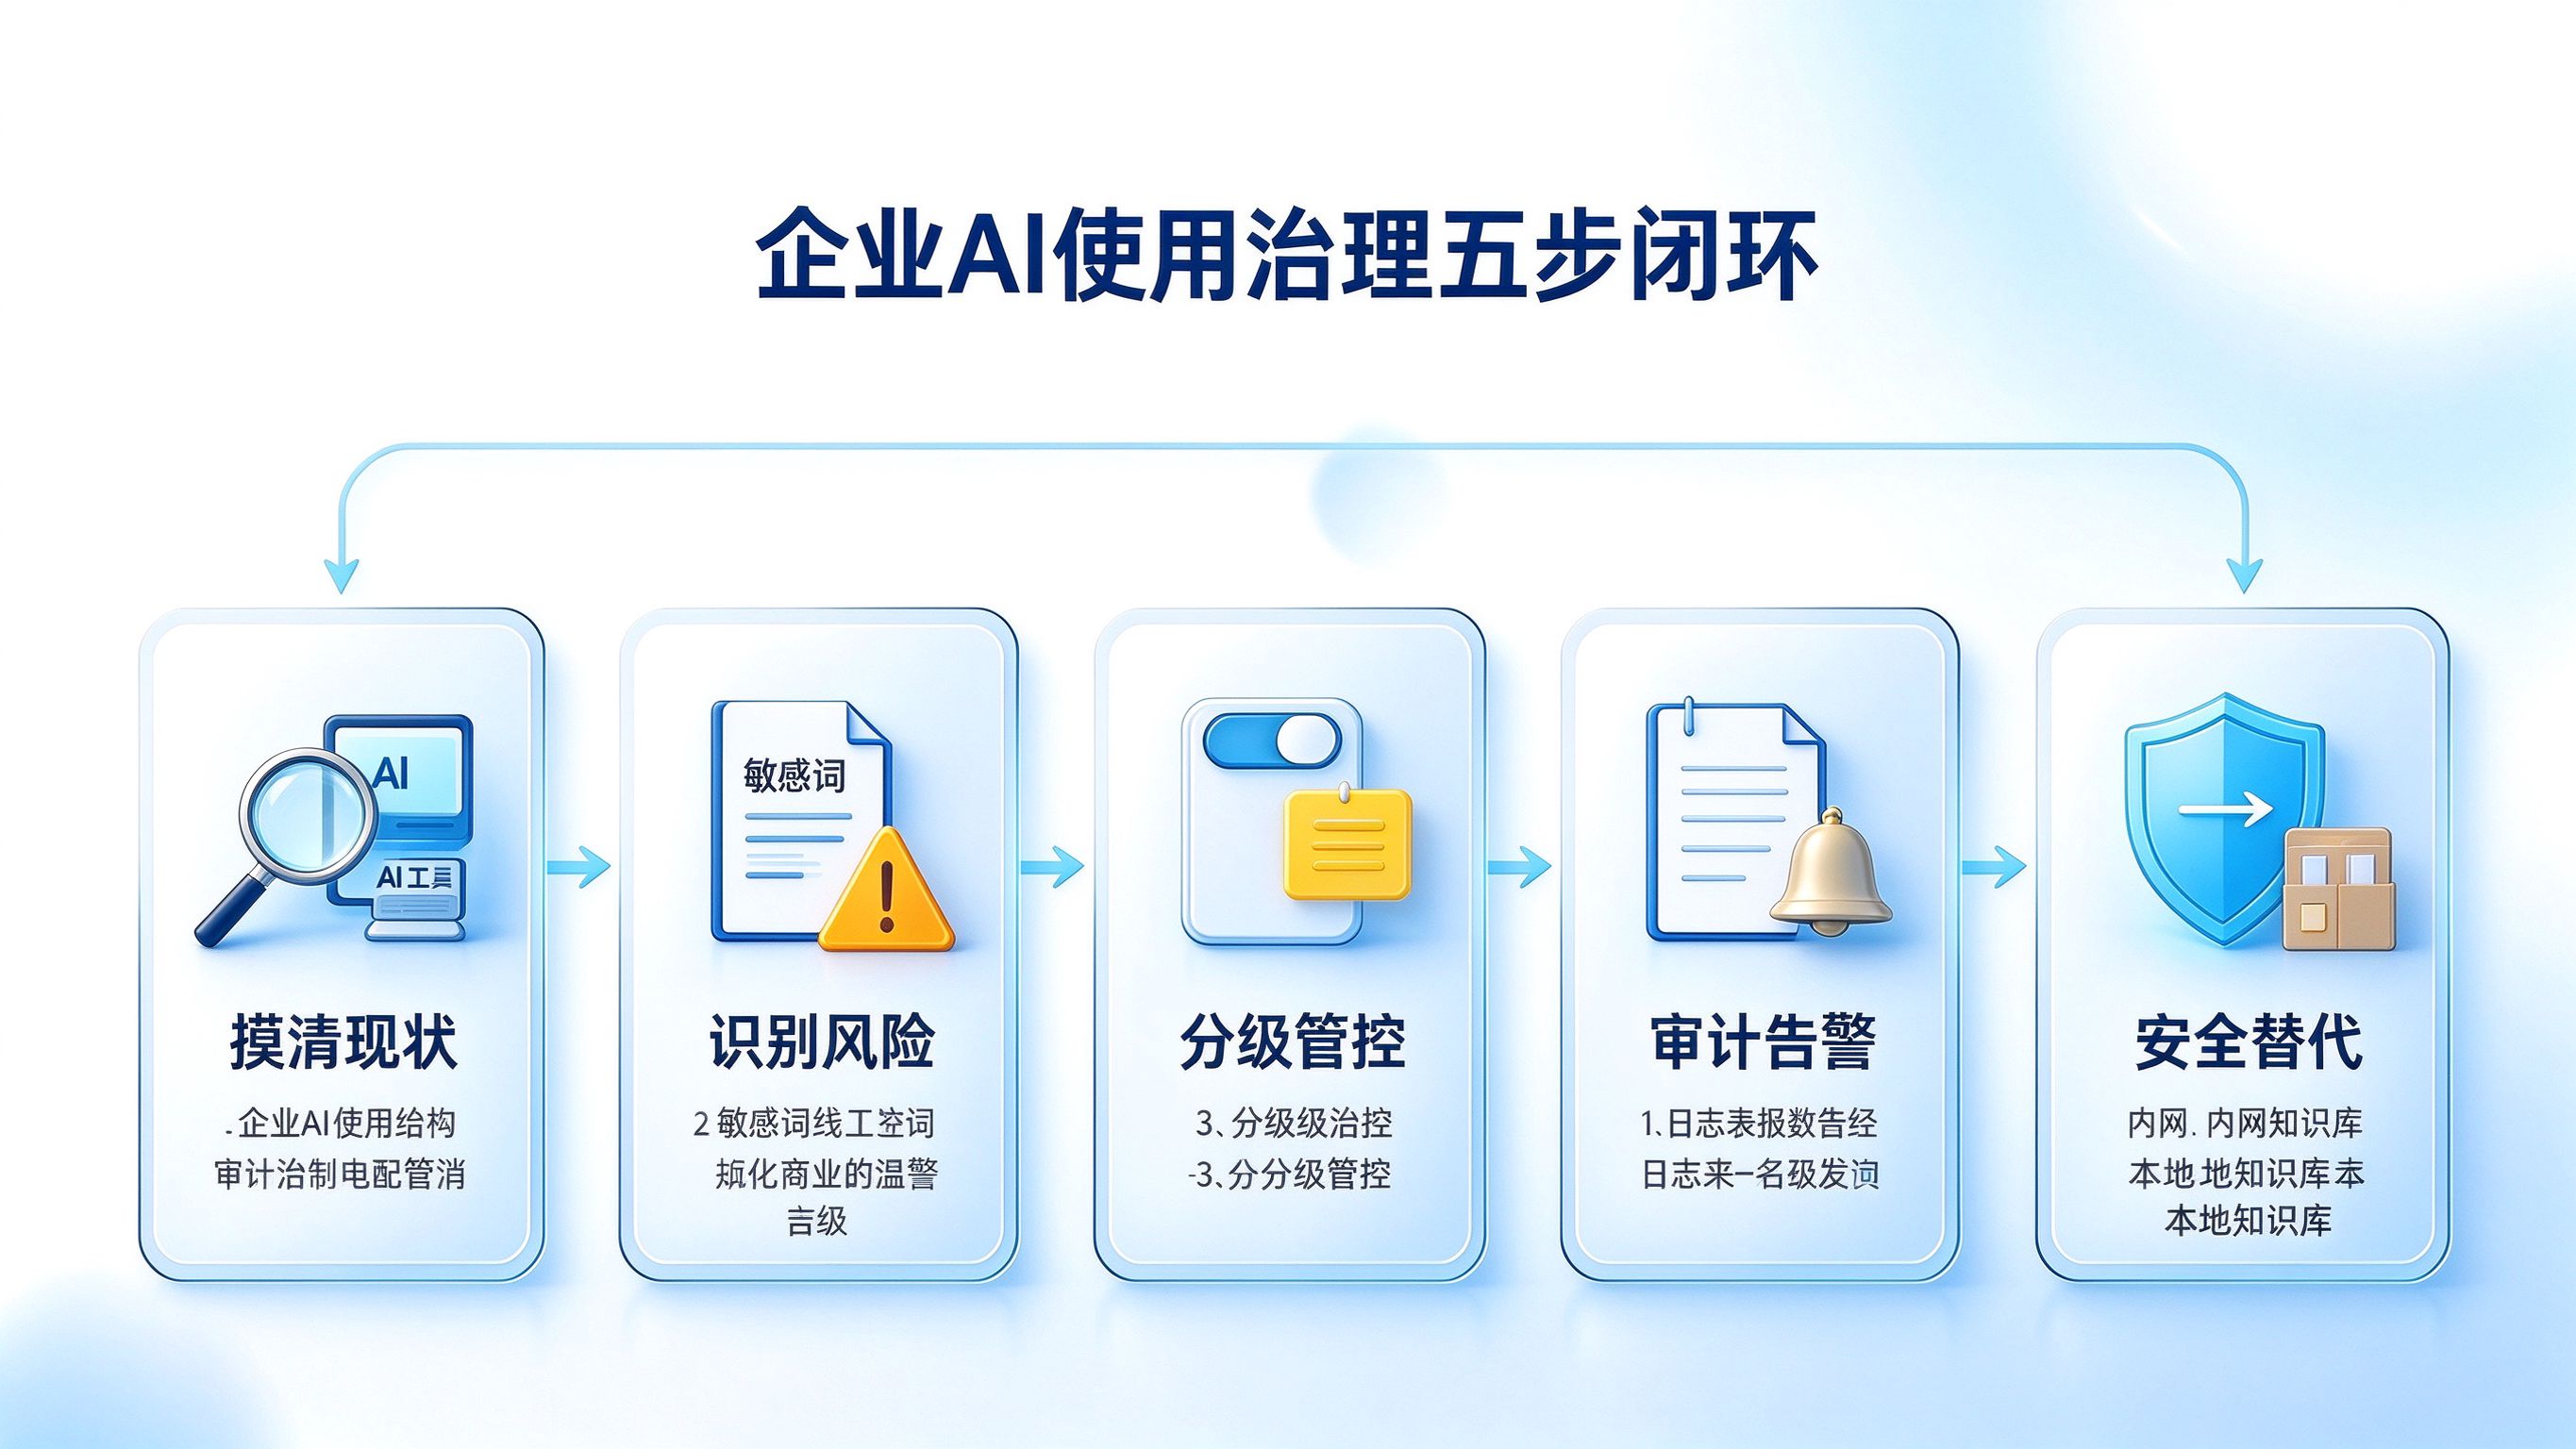
第 1 周:摸清现状,先审计不管控
这一周什么都不封,只做一件事——把 AI 使用情况看清楚。
部署终端审计,覆盖豆包、千问、DeepSeek、元宝、Mimo 等主流工具,记录使用人、部门、工具类型、进程、提问内容和时间;
同时把网页版、IDE 插件入口也纳入(程序员大量走插件,最容易漏);
一周后拉数据:哪些 AI 在用、哪些部门用得最多、有没有贴敏感内容。
这一步的价值是:用真实数据说话,而不是凭感觉。 我把审计结果给业务部门看,大家自己都吓一跳——确实有不少代码、客户名单被贴出去了。有了共识,后面管控才不引发对立。
第 2 周:识别风险 + 分级管控
摸清现状后,开始做内容识别和分级管控。
内容识别:对提示词和上传的附件做检测,识别源代码、客户数据、未公开方案、内部代号;结合剪贴板、文件操作、多轮对话的上下文判断风险(单看一条可能不敏感,连起来就有问题)。
分级管控,把 AI 工具分三类:
可用:相对可控、可对接的工具,正常用,但全程审计;
受限:限制上传文件、限制敏感内容,网页版做访问控制;
禁用:明确不合规的工具,应用程序拦截启动 + 网页域名阻断 + 防火墙联动。
这一步特别强调多点联动:只封客户端没用,网页版、插件、个人热点都得覆盖,否则轻易绕过。
第 3 周:上线合规替代 + 完善告警
这是最关键的一周——堵住公有 AI 的同时,必须给员工一个安全的 AI 用。
上线私有化知识库:把内部文档、产品资料集中导入,员工照常通过 AI 检索、问答,但资料不出内网;
接入企业专属模型(通过 API Key 对接,配置数据源范围和脱敏规则);
完善异常告警:短时间大量提问、命中敏感信息、深夜异常使用、集中上传文件,自动告警;
全程日志留痕,支持按人员、工具、时间检索导出。
私有化替代上线后,员工的接受度明显高了——因为他们发现"合规的 AI 一样好用",没必要再绕。
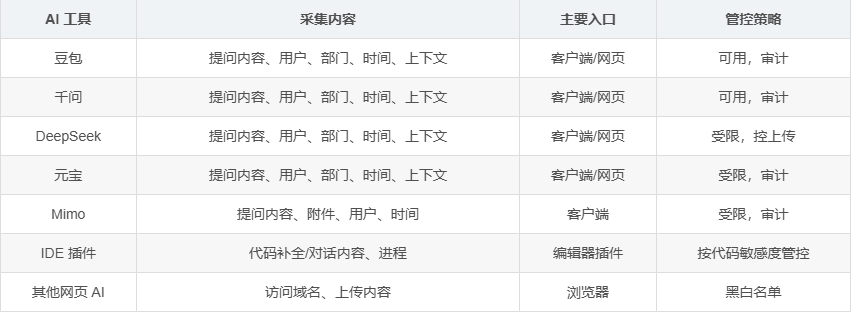
三、AI 工具审计速查表
落地时我整理了一张速查表,直接对应采集点和管控策略,分享给大家:
四、踩过的坑
只封客户端,漏了网页版:第一次管控没做网络侧,员工改用网页版继续用,后来网站控制 + 防火墙补上才堵住;
IDE 插件漏采:程序员走插件没有独立窗口,差点成为盲区,后来按进程和 AI 域名补采;
关键词误报严重:规则太严,正常提问也被拦,后来改成结合文件路径、上下文判断,先宽后紧;
只堵不疏,员工想绕行:前两周没给替代方案,抵触情绪大,私有化知识库上线后才顺;
数据采集要走终端侧:网页版是 HTTPS 加密,旁路抓包拿不到明文,必须在终端代理或可信网关做。
五、最终用的方案
我们最终没有自己开发(评估过,提示词采集、内容识别、管控、私有化每一环工程量都不小,终端侧还要保证稳定性,小团队扛不住),而是直接采购了成品。
落地用的是迪康端点安全一体化管理系统(原迪康 Defender),选它主要是因为 AI 工具审计、提示词识别、应用和网络管控、私有化知识库、模型接入都在一套平台上,不用再拼多个系统。
在迪康端点安全一体化管理系统(原迪康 Defender)上,AI 提问内容、剪贴板、文件操作、上网等数据共用一套终端代理,能串起来看上下文,这对判断"是否泄密"很关键。后面做风险追溯和定期行为报告,也是在迪康端点安全一体化管理系统(原迪康 Defender)上直接出。
总结
AI 泄密这件事,本质是"员工把敏感数据,在向 AI 请教的过程中发给了第三方"。它防不住的原因,往往是企业既看不见提示词内容,又没给员工安全的替代方案。我们的三周实践证明:先审计看清现状、再识别和分级管控、最后用私有化知识库给出合规出口,是一条员工能接受、业务也能接受的路径。
不需要把 AI 当敌人,把它放进规则里,让数据在可控范围内流动,效率和安全完全可以兼得。